Const-me/Whisper (GPU, medium) 조합은 윈도우(Windows) 환경에서 파이토치(PyTorch)나 CUDA의 무거운 종속성 없이 DirectCompute 알고리즘을 활용해 극한의 추론 속도를 내는 매우 효율적인 STT(음성 인식) 세팅입니다. 원본 대비 수십 배 가벼운 용량(약 431KB 수준)으로 구동되며, NVIDIA뿐만 아니라 AMD 및 Intel 내장 GPU에서도 하드웨어 가속을 완벽하게 지원하는 것이 가장 큰 특징입니다.
현재 시장에서 주로 사용되는 대표적인 Whisper 파생 엔진들과 비교한 결과는 다음과 같습니다.
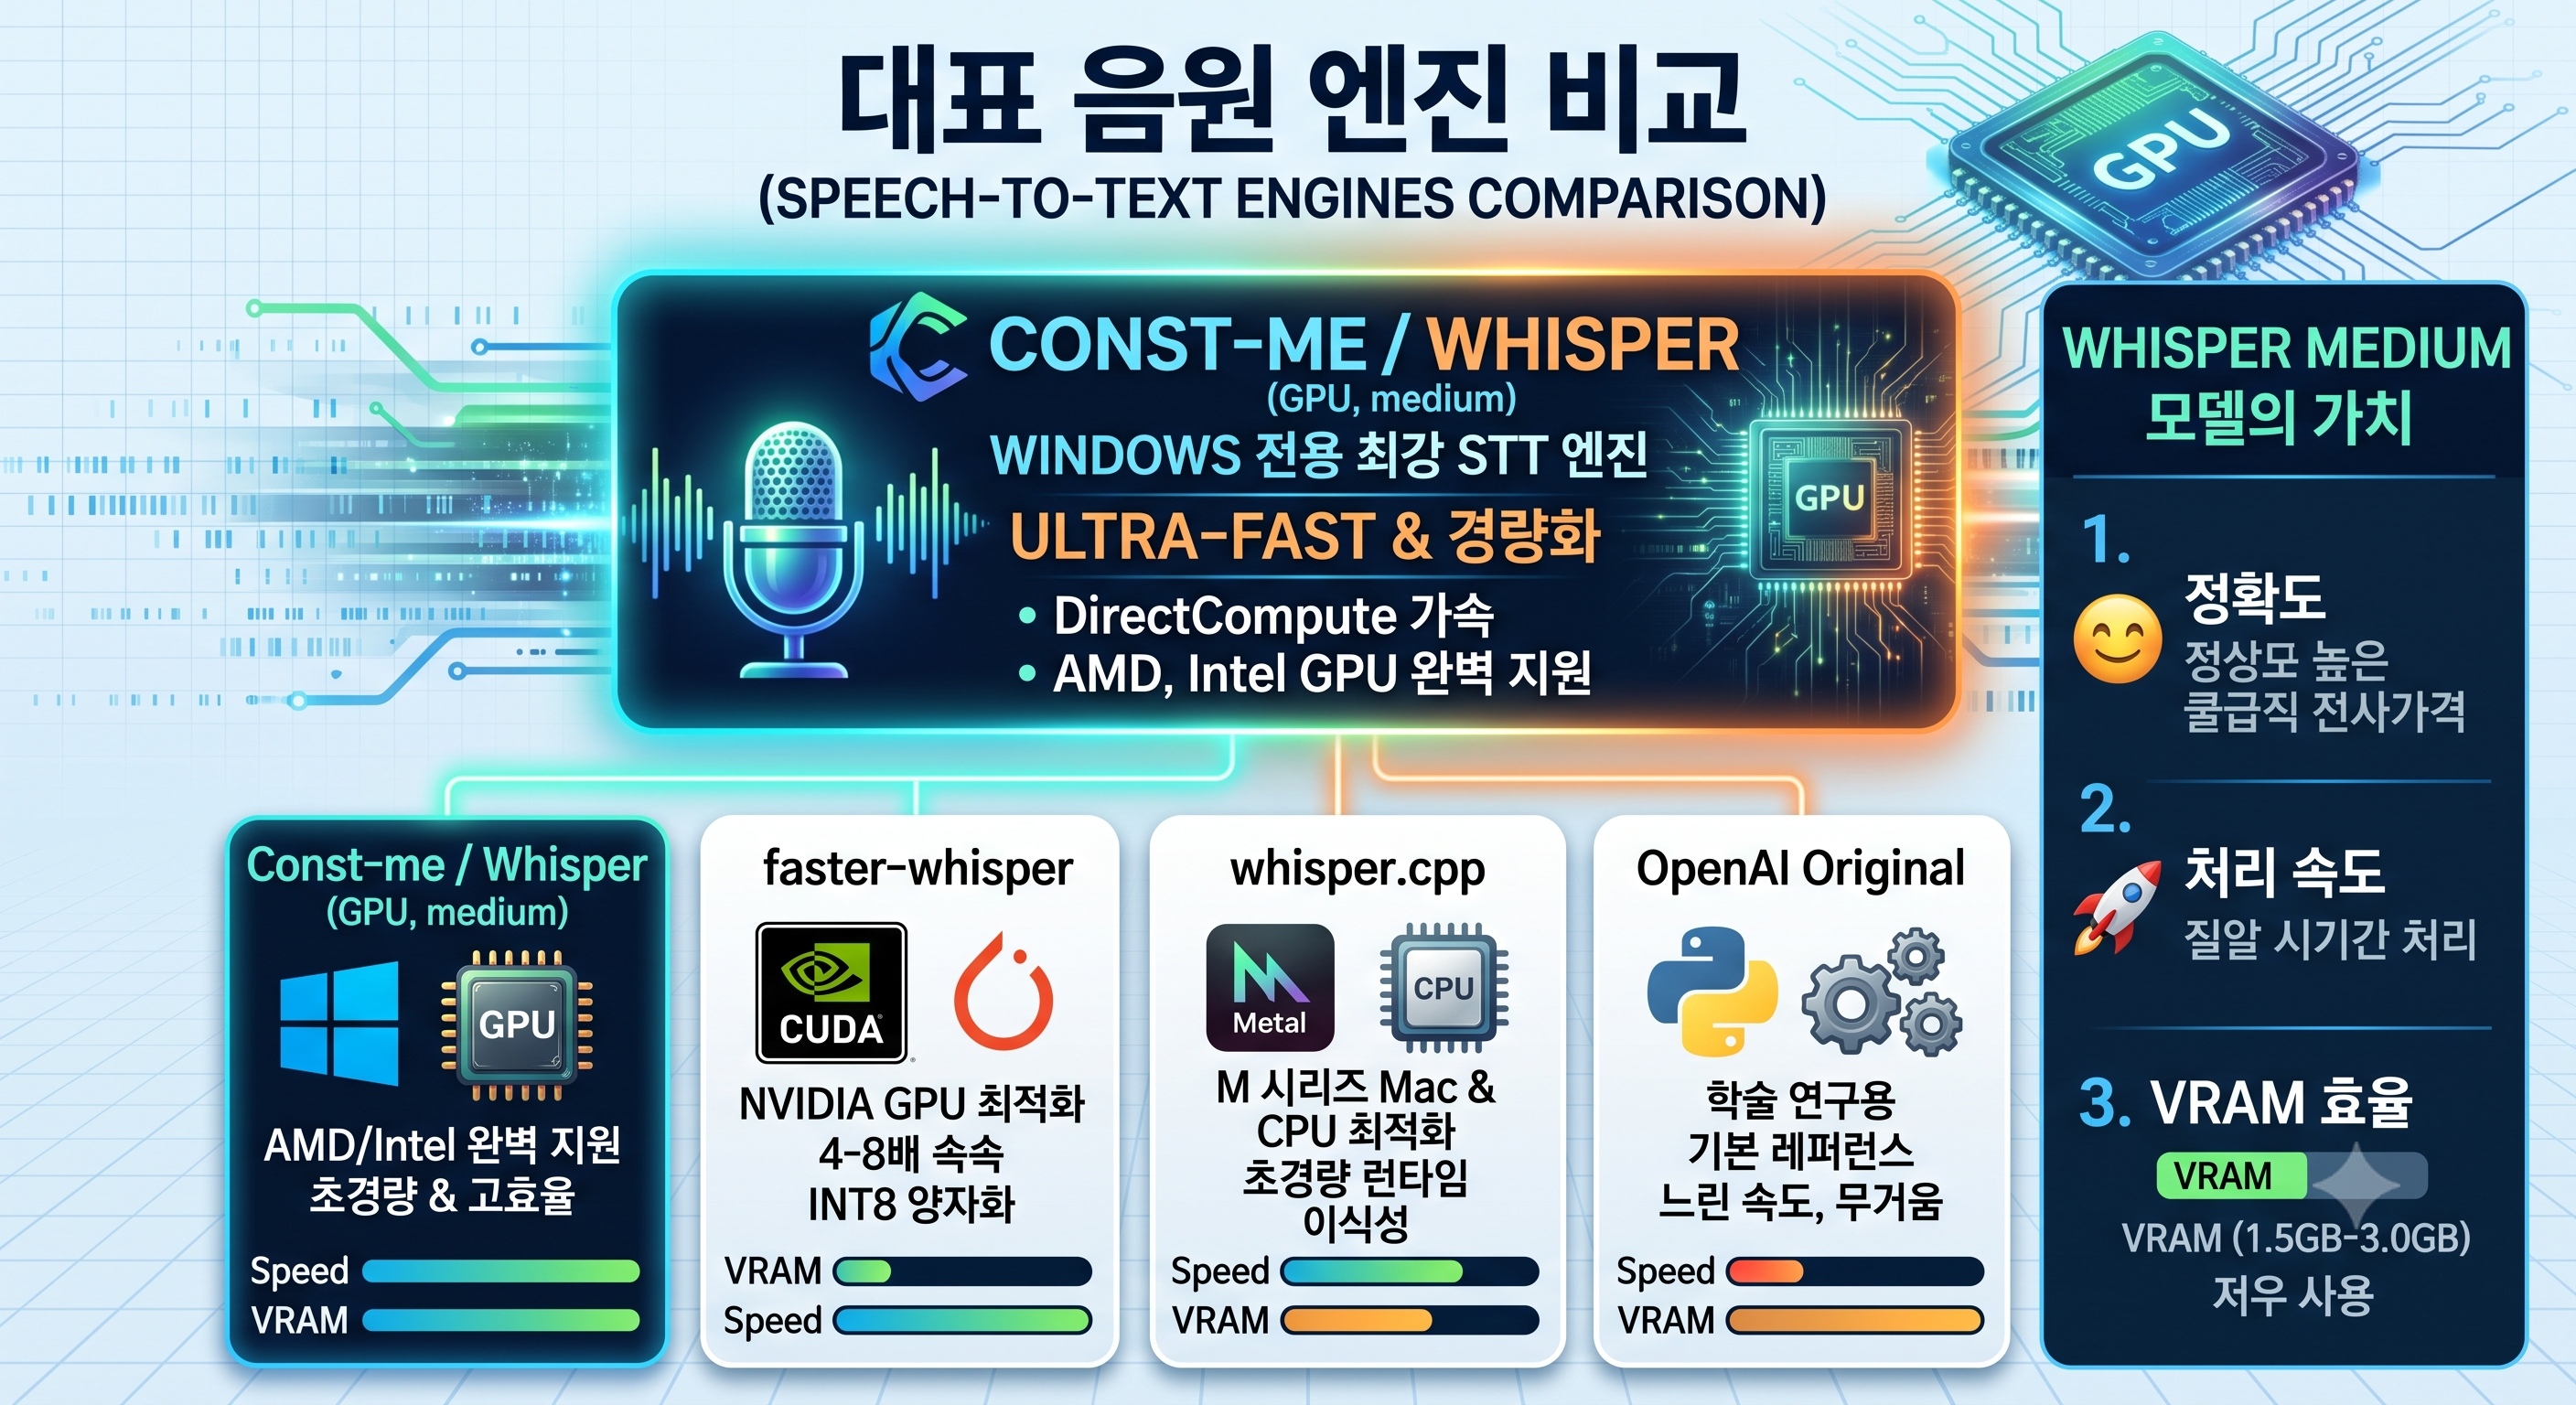
대표 Whisper 엔진 비교
| 엔진 (구현체) | 기반 기술 및 백엔드 | 주요 장점 | 주요 단점 | 최적의 사용 환경 |
| Const-me/Whisper | C++, DirectCompute | CUDA 불필요(AMD/Intel 완벽 지원), 초경량 파일 크기, 윈도우 환경 극강의 속도 | 윈도우 OS 전용, Python 생태계와의 직접적인 통합이 다소 까다로움 | 윈도우 데스크탑 (다양한 제조사의 GPU 혼용 환경) |
| faster-whisper | CTranslate2, CUDA | 원본 대비 4~8배 빠른 속도, INT8 양자화 지원, Python 생태계 연동 용이 | NVIDIA GPU(CUDA) 의존도가 높음, 무거운 런타임 종속성 | NVIDIA GPU 기반의 서버 및 백엔드 자동화 서비스 |
| whisper.cpp | C/C++, GGML | Apple Silicon (Metal) 및 CPU 최적화 압도적, 엣지 기기 이식성 우수 | 윈도우 및 외장 GPU 환경에서는 타 엔진 대비 성능 우위가 크지 않음 | Mac 환경, 리눅스 CPU 전용 서버 |
| OpenAI Original | PyTorch, CUDA | 최신 모델 및 기능이 가장 먼저 반영되는 공식 레퍼런스 | 추론 속도가 가장 느림, 9GB 이상의 막대한 런타임 용량 요구 | 학술 연구, 새로운 모델의 정확도 베이스라인 테스트 |
엔진별 상세 특성 및 활용성
- Const-me/Whisper의 강점: Windows의 Direct3D 11.0 이상을 지원하는 모든 GPU에서 동작하므로 하드웨어 호환성이 가장 뛰어납니다. C# 래퍼(Wrapper)나 DLL 형태로 제공되어 윈도우 네이티브 애플리케이션에 내장하기 좋으며, 무거운 런타임 없이 독립적인 실행 파일로 구동할 때 가장 쾌적합니다.
- 개발 및 서버 연동 (faster-whisper): 웹 애플리케이션이나 자동화 파이프라인의 백엔드로 Whisper를 올려야 한다면 faster-whisper가 산업 표준에 가깝습니다. CTranslate2를 통해 VRAM 사용량을 대폭 낮추고 동시 처리량을 크게 늘릴 수 있습니다.
- Mac 및 경량화 환경 (whisper.cpp): C++로 바닥부터 재작성되어 CPU 추론 성능을 극대화한 버전입니다. GPU가 없는 환경이나 M 시리즈 칩셋을 사용하는 Mac에서 훌륭한 퍼포먼스를 보여줍니다.
GPU 환경에서 Medium 모델의 가치
Medium 모델(약 7억 6,900만 파라미터)은 정확도와 연산 비용 사이에서 가장 이상적인 타협점을 제공합니다.
- 정확도 (Accuracy): Large-v3 모델과 비교했을 때 벤치마크 상 단어 오류율(WER) 차이가 미미하며, 영어뿐만 아니라 한국어 음성 인식에서도 비즈니스 통화나 회의록 작성에 충분한 고품질 전사가 가능합니다.
- 처리 속도 (Speed): Large 모델에 비해 연산량이 적어 약 2배 이상 빠른 추론 속도를 보장합니다. 일반적인 데스크탑 GPU에서 오디오 실제 길이보다 훨씬 빠른 속도(Real-Time Factor 1.0 이하)로 실시간 처리가 가능합니다.
- VRAM 효율성: Large-v3 모델이 최소 6GB 이상의 VRAM을 요구하는 반면, Medium 모델은 FP16 기준으로도 1.5GB ~ 3.0GB 수준의 VRAM만으로 안정적으로 로드되므로 다른 작업과 병행하며 여유로운 구동이 가능합니다.
'AI & 코딩' 카테고리의 다른 글
| CUDA 없는 AMD 그래픽카드로 AI 영상 편집? 잡담 자동 제거 프로그램을 직접 만들어봤다 (0) | 2026.09.16 |
|---|---|
| Playwright 완벽 가이드: Selenium을 대체할 차세대 웹 자동화 및 E2E 테스트 프레임워크 (0) | 2026.09.11 |
| 웹사이트를 구경하다가 실수로 'F12' 키를 눌러본 적 있나요? (0) | 2026.09.09 |
| 클라우드 및 AI API 서비스에 '과금 티어(Tier)'가 존재하는 진짜 이유: 요금 폭탄부터 인프라 보호까지 (0) | 2026.08.31 |
| Gemini Notebook 사용량 한도 정책 개편 안내 (2026년 9월 2일 적용) (0) | 2026.08.29 |